

Wir haben unsere LLMs durch Jev ersetzt. Das ist 39 % günstiger.
Explore with AI
Wir bauen einen durchgehend aktiven On-Call-Agenten, der ständig Entscheidungen trifft, zum Beispiel:
- Wie schwerwiegend ist dieses Problem?
- Sollten wir in diesem Slack-Thread proaktiv werden?
- Haben wir diesen Incident schon einmal gesehen?
Bis letzte Woche haben wir für diese Aufgaben LLMs verwendet. Sobald wir diese Woche Zugang zu Jev hatten, haben wir angefangen, damit zu experimentieren.
Was ist Jev?
Jev ist ein Entscheidungsmodell von TypeSafe AI. Es generiert keinen Text, sondern beantwortet Fragen zu deinen Daten mit typisierten Werten und kalibrierten Wahrscheinlichkeiten. TypeSafe bewirbt es für „intelligente If-Anweisungen“ – die Klassifizierungs-, Routing- und Bewertungsschritte, bei denen handgeschriebene Logik zu brüchig ist – und nennt 70 bis 500 ms pro Antwort bei kostenlosen Output-Tokens. Unsere Agenten treffen solche Entscheidungen den ganzen Tag, also haben wir es in Produktion gebracht.
Wie es funktioniert
Eine Anfrage besteht aus zwei Teilen: dem state, also dem Text oder JSON, zu dem du eine Entscheidung möchtest, und den questions, die beantwortet werden sollen. Jede Frage hat einen von drei Typen:
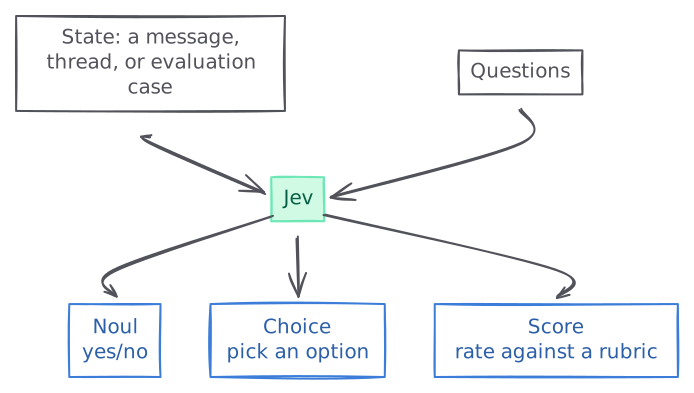
- Noul gibt die Wahrscheinlichkeit für
yeszurück. - Choice wählt eine der angegebenen Optionen aus.
- Score gibt einen wahrscheinlichkeitsgewichteten Wert über eine geordnete Bewertungsskala zurück.
Anwendungsfall 1: Routing, oder wann sollte der Agent antworten?
Unsere Agenten sind auf Slack und Github proaktiv. Sie antworten auf Slack-Nachrichten oder Github-Kommentare, wenn sie dem Nutzer eine sinnvolle Einschätzung geben können. Die Agenten müssen handeln, wenn ein Nutzer es verlangt, ohne auf jedes Ereignis überzureagieren. Das ist ein perfekter Anwendungsfall für Jevs Noul-Fragen.
- Kommentare zu Pull Requests, die unsere Agenten eingereicht haben: Wenn ein Reviewer eine Änderung verlangt, wacht der Agent auf. Ein CI-Status-Update oder ein „Danke“ tut das nicht.
- Slack-Channels: Der Agent meldet sich ungefragt nur dann zu Wort, wenn er eindeutig helfen kann, etwa bei einer direkten Infrastrukturfrage. Er hält sich raus, wenn sich Menschen untereinander abstimmen.
- Slack-Threads, in denen der Agent ist: Er beantwortet Nachrichten, die für ihn bestimmt sind, ignoriert Menschen, die miteinander reden, und verlässt den Thread, wenn jemand ihn darum bittet.
Hier ist ein Beispiel für eine Jev-Anfrage, um zu bestimmen, ob ein Agent auf eine Slack-Nachricht reagieren sollte.
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
Wir haben Jev etwa eine Woche laufen lassen und mit dem LLM verglichen, das wir zuvor für diese Aufgabe verwendet haben.
P90 latency
Cost per 1,000 calls
Das Routing wurde bei P90 3-mal schneller, von 1,5 Sekunden auf unter 500 ms, und die Kosten sanken um fast die Hälfte.
Anwendungsfall 2: Klassifizierung, oder was bedeutet die Evidenz?
Wir führen außerdem einige Aufgaben aus, bei denen der Agent Dinge in verschiedene Kategorien einordnen muss. Soll der Agent zum Beispiel anhand der vorliegenden Evidenz beginnen, das Problem zu untersuchen, soll er es als verwandt mit einem bestehenden Problem einordnen, oder handelt es sich um ein Duplikat eines bereits gelösten Problems?
Eine Jev-Choice-Frage verwandelt diese Evidenz in ein Label aus von uns definierten Kriterien, und der nächste Schritt wird anhand dieses Labels entschieden. Das sieht so aus:
Wir führen auf diese Weise drei Klassifizierungen durch. Jede verwendet eine Choice-Frage mit expliziten Kriterien, und jede hat ein anderes LLM ersetzt, daher haben wir sie einzeln gemessen.
Sind diese Incidents miteinander verbunden?
Wenn ein neuer Incident eröffnet wird, vergleicht der Agent ihn mit bestehenden Incidents: Teilen sie eine Root Cause, sind sie verwandt, oder sind sie unabhängig voneinander? Dieses veranschaulichende Beispiel zeigt einen Kandidaten; ein Produktionsaufruf vergleicht mehrere gegen denselben neuen Incident.
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
Durch den Wechsel zu Jev für diesen Anwendungsfall wurde es bei P90 fast 8-mal schneller, von 2,9 Sekunden auf unter 400 ms, und 27 % günstiger.
P90 latency
Cost per 1,000 calls
Warum wurde dieser von uns eingereichte Pull Request geschlossen?
Unsere Agenten reichen Pull Requests bei Entwicklern ein, und eine unserer wichtigsten Erfolgskennzahlen ist die Merge-Rate. Wir müssen verstehen, warum Pull Requests geschlossen werden, um das Produkt verbessern zu können.
Wenn einer unserer Pull Requests geschlossen wird, ohne gemergt zu werden, liest der Agent die Reviews, die Diskussion und Verweise auf andere Arbeiten und wählt dann den Grund aus: Der Fix war falsch, ein Mensch hat es anders gelöst, das Problem war ein Fehlalarm, der Pull Request ist veraltet, oder das Verhalten war beabsichtigt.
Durch den Wechsel zu Jev für diesen Anwendungsfall haben wir die Latenz bei P90 auf das 6-Fache verbessert, aber nur 17 % günstiger gemacht.
P90 latency
Cost per 1,000 calls
Wie dringend ist dieser Pull Request?
Bevor unsere Agenten einen Pull Request bei Entwicklern einreichen, müssen sie ihn einstufen, damit Dinge mit höherer Schwere nach oben steigen. Für diese Klassifizierung bewertet der Agent das zugrunde liegende Problem auf einer Skala von kritisch bis info. Er bewertet die aktuelle Auswirkung, nicht ein hypothetisches Risiko.
P90 latency
Cost per 1,000 calls
Der Wechsel zu Jev hat hier die Kosten deutlich gesenkt: 59 % günstiger als DeepSeek V4.1 Flash, und bei P90 fast 5-mal schneller.
Jev ist bei jeder Klassifizierung schneller. Wo es GPT-OSS 120B ersetzt hat, liegt der Gewinn vor allem in der Latenz. Wo es DeepSeek V4.1 Flash ersetzt hat, hat es die Kosten außerdem um mehr als die Hälfte gesenkt.
Anwendungsfall 3: Ranking, oder wie wichtig ist diese Cloud-Ressource?
Um das Beste aus Polylane herauszuholen, verbinden Teams ihre Cloud-Konten. Wir erstellen einen Context Graph aller Cloud-Ressourcen, damit die Agenten die Beziehung zwischen Compute-Knoten, Datenbanken, Queues usw. schnell verstehen können.
Auf der Plattform gibt es Teams mit extrem stark ausgelasteten Cloud-Konten mit Zehntausenden von Knoten. Jeder Server, jede Sandbox, jede Datenbank und jede Queue ist ein Knoten in unserem Context Graph. Es ist notwendig, jeden dieser Knoten einzustufen, damit die Agenten wissen, was für deine Anwendung kritisch ist und was im Grunde bedenkenlos ausfallen darf.
Wir weisen jeder Ressource eine von vier Prioritätsstufen zu: Critical, Standard, Low oder Minimal.
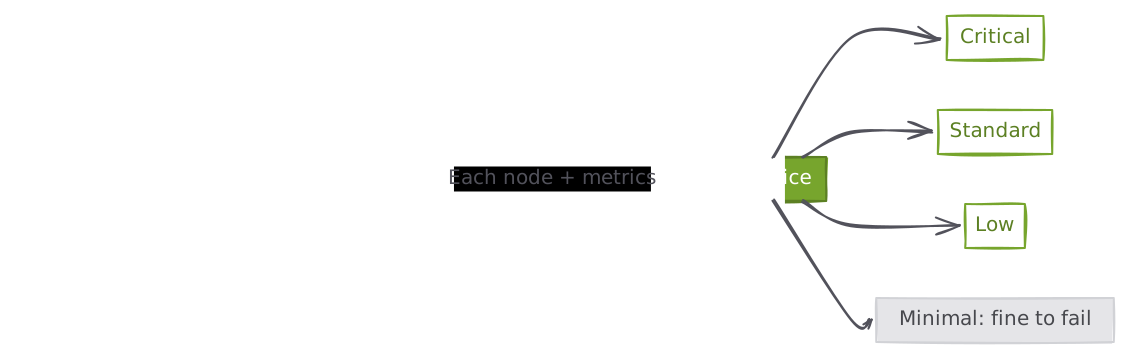
Jev wertet für jede Ressource eine Choice-Frage aus, mit Kontext basierend auf Konfiguration, Umgebung, aktuellen Metriken und Abhängigkeiten.
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
Beim Ranking glänzt Jev am meisten: bei P90 mehr als 10-mal schneller, von 5,4 Sekunden auf etwa eine halbe Sekunde, und 34 % günstiger. Es ist außerdem unsere Entscheidung mit dem höchsten Volumen, daher treibt sie den Großteil der Gesamteinsparungen an.
P90 latency
Cost per 1,000 calls
Zusammenfassung
Insgesamt hat Jev deutliche Reduktionen bei Latenz und geschätzten Kosten pro 1.000 Aufrufe geliefert:
- Reduktion der P90-Latenz: 4.752 ms —> 508 ms.
- Reduktion der Kosten pro 1.000 Aufrufe: $0.76199 —> $0.46369.
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is betterPro Modell ist Jev sowohl am schnellsten als auch am günstigsten: etwas günstiger als DeepSeek V4.1 Flash und deutlich unter beiden GPT-OSS-Modellen.
Swipe to see every point.
Überall dort, wo unsere Agenten aus einer festen Menge an Antworten wählen, ist Jev jetzt die Standardwahl: Es ist bei jeder Entscheidung, die wir umgestellt haben, schneller und günstiger.