

Nous avons remplacé nos LLM par Jev. C'est 39 % moins cher.
Explore with AI
Nous construisons un agent on-call toujours actif, qui prend constamment des décisions, par exemple :
- quelle est la gravité de cette issue ?
- devons-nous être proactifs sur ce thread Slack ?
- avons-nous déjà vu cet incident ?
Jusqu’à la semaine dernière, nous utilisions des LLM pour ces tâches. Dès que nous avons eu accès à Jev cette semaine, nous avons commencé à l’expérimenter.
Qu’est-ce que Jev ?
Jev est un modèle de décision de TypeSafe AI. Il ne génère pas de texte : il répond à des questions sur tes données avec des valeurs typées et des probabilités calibrées. TypeSafe le présente comme des « instructions if intelligentes », les étapes de classification, de routage et de notation où la logique écrite à la main devient trop fragile, et annonce entre 70 et 500 ms par réponse avec des tokens de sortie gratuits. Nos agents prennent ces décisions toute la journée, nous l’avons donc mis en production.
Comment ça fonctionne
Une requête comporte deux parties : state, le texte ou JSON sur lequel tu veux une décision, et questions, les questions auxquelles tu veux une réponse. Chaque question a l’un des trois types suivants :
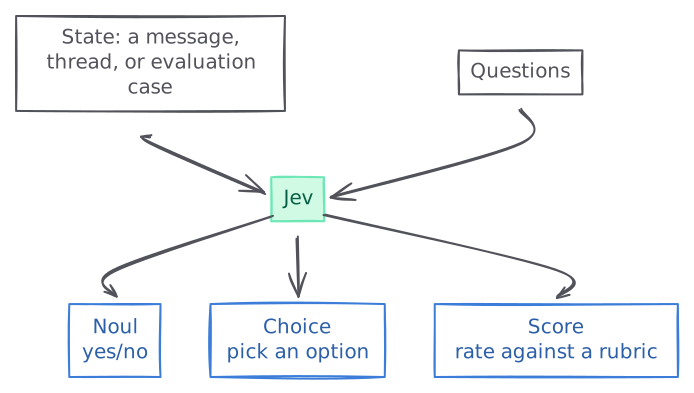
- Noul renvoie la probabilité de
yes. - Choice sélectionne l’une des options fournies.
- Score renvoie une valeur pondérée par probabilité sur une grille ordonnée.
Cas d’usage 1 : routage, ou quand l’agent doit-il répondre ?
Nos agents sont proactifs sur Slack et Github. Ils répondent aux messages Slack ou aux commentaires Github lorsqu’ils ont un élément pertinent à apporter à l’utilisateur. Les agents doivent agir quand un utilisateur le demande, sans réagir de façon excessive à chaque événement. C’est un cas d’usage parfait pour les questions Noul de Jev.
- Commentaires sur les PR soumises par nos agents : un relecteur qui demande une modification réveille l’agent. Une mise à jour du statut de CI ou un « merci » ne le fait pas.
- Canaux Slack : l’agent intervient sans y être invité uniquement quand il peut clairement aider, comme pour une question d’infrastructure directe. Il reste en dehors des échanges entre humains.
- Threads Slack où l’agent est présent : il répond aux messages qui lui sont destinés, ignore les humains qui se parlent entre eux, et s’en va quand on le lui demande.
Voici un exemple de requête Jev pour déterminer si un agent doit donner suite à un message Slack.
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
Nous avons fait tourner Jev pendant environ une semaine et comparé avec le LLM que nous utilisions auparavant pour cette tâche.
P90 latency
Cost per 1,000 calls
Le routage est devenu 3 fois plus rapide au P90, passant de 1,5 seconde à moins de 500 ms, et le coût a chuté de près de moitié.
Cas d’usage 2 : classification, ou que signifient les preuves ?
Nous exécutons aussi quelques tâches où l’agent doit classer des éléments dans différentes catégories. Par exemple, en fonction des preuves fournies, l’agent doit-il commencer à enquêter sur l’issue, doit-il la rattacher à une issue existante, ou s’agit-il d’un doublon d’une issue déjà résolue ?
Une question Jev de type Choice transforme ces preuves en une étiquette parmi des critères que nous définissons, et l’étape suivante est décidée par cette étiquette. Voici à quoi cela ressemble :
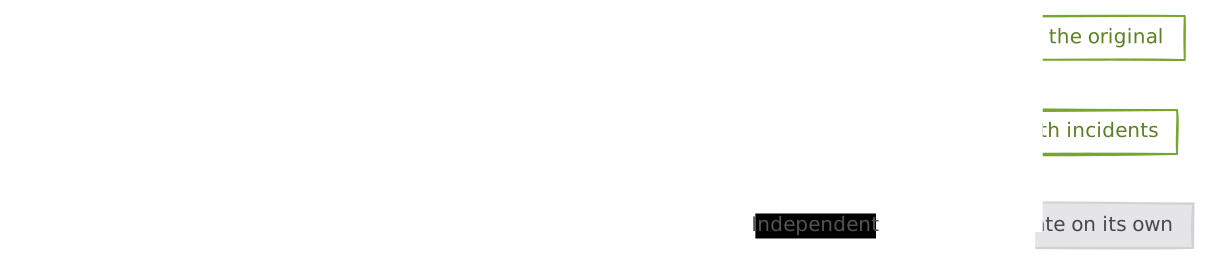
Nous procédons ainsi pour trois classifications. Chacune utilise une question Choice avec des critères explicites, et chacune a remplacé un LLM différent, nous les avons donc mesurées séparément.
Ces incidents sont-ils liés ?
Quand un nouvel incident s’ouvre, l’agent le compare aux incidents existants : partagent-ils une cause racine, sont-ils liés, ou sont-ils indépendants ? Cet exemple illustratif montre un seul candidat ; un appel en production en compare plusieurs par rapport au même nouvel incident.
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
En passant à Jev pour ce cas d’usage, nous l’avons rendu presque 8 fois plus rapide au P90, passant de 2,9 secondes à moins de 400 ms, et 27 % moins cher.
P90 latency
Cost per 1,000 calls
Pourquoi cette pull request que nous avons soumise a-t-elle été fermée ?
Nos agents soumettent des pull requests aux développeurs, et l’une de nos métriques clés de succès est le taux de fusion. Nous devons comprendre pourquoi des pull requests sont fermées afin de pouvoir améliorer le produit.
Quand l’une de nos PR est fermée sans être fusionnée, l’agent lit les revues, la discussion et les références à d’autres travaux, puis choisit la raison : le correctif était erroné, un humain l’a corrigé autrement, l’issue était un faux positif, la PR est devenue obsolète, ou le comportement était voulu.
En passant à Jev pour ce cas d’usage, nous avons rendu la latence 6 fois plus rapide au P90, mais seulement 17 % moins cher.
P90 latency
Cost per 1,000 calls
À quel point cette pull request est-elle urgente ?
Avant de soumettre une pull request aux développeurs, nos agents doivent la classer afin que les éléments de gravité plus élevée remontent en tête de liste. Pour cette classification, l’agent évalue le problème sous-jacent sur une échelle allant de critique à info. Il évalue l’impact actuel, pas un risque hypothétique.
P90 latency
Cost per 1,000 calls
Passer à Jev ici a nettement réduit le coût : 59 % moins cher que DeepSeek V4.1 Flash, et presque 5 fois plus rapide au P90.
Jev est plus rapide sur chaque classification. Là où il a remplacé GPT-OSS 120B, le gain porte surtout sur la latence. Là où il a remplacé DeepSeek V4.1 Flash, il a aussi réduit la facture de plus de moitié.
Cas d’usage 3 : classement, ou quelle est l’importance de cette ressource cloud ?
Pour tirer le meilleur parti de Polylane, les équipes connectent leurs comptes cloud. Nous créons un context graph de toutes les ressources cloud, afin que les agents puissent rapidement comprendre les relations entre nœuds de calcul, bases de données, files d’attente, etc.
Nous avons des équipes sur la plateforme avec des comptes cloud extrêmement chargés, comportant des dizaines de milliers de nœuds. Chaque serveur, sandbox, base de données et file d’attente est un nœud dans notre context graph. Il est nécessaire de classer chacun de ces nœuds afin que les agents sachent ce qui est critique pour ton application, et ce qui peut essentiellement échouer sans conséquence.
Nous attribuons à chaque ressource l’un des quatre niveaux de priorité : Critical, Standard, Low ou Minimal.
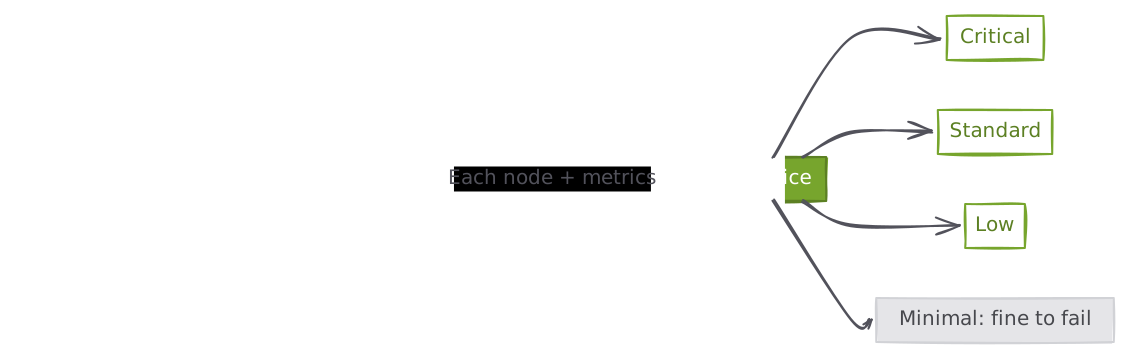
Jev évalue une question Choice pour chaque ressource, avec un contexte basé sur la configuration, l’environnement, les métriques récentes et les dépendances.
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
Le classement est là où Jev excelle : plus de 10 fois plus rapide au P90, passant de 5,4 secondes à environ une demi-seconde, et 34 % moins cher. C’est aussi notre décision au plus gros volume, ce qui explique l’essentiel des économies globales.
P90 latency
Cost per 1,000 calls
Résumé
Dans l’ensemble, Jev a apporté des réductions globales substantielles de la latence et du coût estimé pour 1 000 appels :
- Réduction de la latence P90 : 4 752 ms —> 508 ms.
- Réduction du coût pour 1 000 appels : $0.76199 —> $0.46369.
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is betterPar modèle, Jev est à la fois le plus rapide et le moins cher : légèrement moins cher que DeepSeek V4.1 Flash, et bien en dessous des deux modèles GPT-OSS.
Swipe to see every point.
Partout où nos agents choisissent parmi un ensemble fixe de réponses, Jev est désormais le choix par défaut : il est plus rapide et moins cher sur chaque décision que nous avons migrée.