

Abbiamo sostituito i nostri LLM con Jev. Costa il 39% in meno.
Explore with AI
Stiamo costruendo un agente in on-call sempre attivo, che prende decisioni in continuazione, ad esempio:
- quanto è grave questa issue?
- dovremmo essere proattivi su questo thread di Slack?
- abbiamo già visto questo incidente in passato?
Fino alla settimana scorsa abbiamo usato LLM per questi compiti. Non appena abbiamo ottenuto l’accesso a Jev questa settimana, abbiamo iniziato a sperimentarlo.
Cos’è Jev?
Jev è un modello decisionale di TypeSafe AI. Non genera testo: risponde a domande sui tuoi dati con valori tipizzati e probabilità calibrate. TypeSafe lo propone per gli “smart if-statements”, i passaggi di classificazione, routing e scoring in cui la logica scritta a mano è troppo fragile, e dichiara tempi di risposta tra 70 e 500 ms con token di output gratuiti. I nostri agenti prendono queste decisioni tutto il giorno, quindi lo abbiamo messo in produzione.
Come funziona
Una richiesta ha due parti: lo state, ovvero il testo o il JSON su cui vuoi una decisione, e le questions a cui vuoi una risposta. Ogni domanda ha uno di tre tipi:
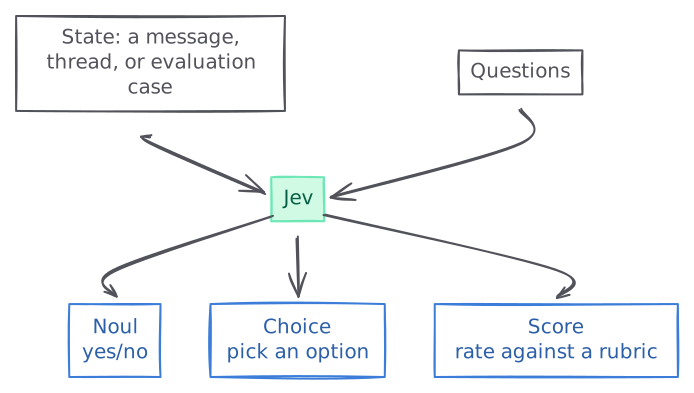
- Noul restituisce la probabilità di
yes. - Choice seleziona una delle opzioni fornite.
- Score restituisce un valore ponderato per probabilità su una rubrica ordinata.
Caso d’uso 1: routing, ovvero quando dovrebbe rispondere l’agente?
I nostri agenti sono proattivi su Slack e Github. Rispondono ai messaggi Slack o ai commenti Github se hanno un’informazione utile da offrire all’utente. Gli agenti devono agire quando un utente lo richiede, senza reagire in modo eccessivo a ogni evento. È un caso d’uso perfetto per le domande Noul di Jev.
- Commenti sulle PR inviate dai nostri agenti: un reviewer che chiede una modifica risveglia l’agente. Un aggiornamento di stato della CI o un “grazie” no.
- Canali Slack: l’agente interviene senza essere invitato solo quando può aiutare in modo chiaro, come una domanda diretta sull’infrastruttura. Resta fuori quando le persone si coordinano tra loro.
- Thread Slack in cui l’agente è presente: risponde ai messaggi rivolti a lui, ignora le persone che parlano tra loro e se ne va quando qualcuno glielo chiede.
Ecco un esempio di richiesta a Jev per determinare se un agente dovrebbe dare seguito a un messaggio Slack.
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
Abbiamo eseguito Jev per circa una settimana e lo abbiamo confrontato con l’LLM che usavamo in precedenza per questo compito.
P90 latency
Cost per 1,000 calls
Il routing è diventato 3 volte più veloce al P90, passando da 1.5 secondi a meno di 500 ms, e il costo è sceso di quasi la metà.
Caso d’uso 2: classificazione, ovvero cosa significano le prove?
Eseguiamo anche alcuni compiti in cui l’agente deve classificare le cose in diverse categorie. Ad esempio, in base alle prove fornite, l’agente dovrebbe iniziare a indagare sull’issue, dovrebbe considerarla correlata a un’issue esistente, oppure è un duplicato di un’issue già risolta?
Una domanda Choice di Jev trasforma quelle prove in un’unica etichetta a partire da criteri che definiamo noi, e il passo successivo viene deciso in base all’etichetta. Funziona così:
Eseguiamo tre classificazioni in questo modo. Ognuna usa una domanda Choice con criteri espliciti, e ognuna ha sostituito un LLM diverso, quindi le abbiamo misurate separatamente.
Questi incidenti sono correlati?
Quando si apre un nuovo incidente, l’agente lo confronta con gli incidenti esistenti: condividono una causa radice, sono correlati o sono indipendenti? Questo esempio illustrativo mostra un solo candidato; una chiamata in produzione ne confronta diversi rispetto allo stesso nuovo incidente.
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
Passando a Jev per questo caso d’uso, lo abbiamo reso quasi 8 volte più veloce al P90, passando da 2.9 secondi a meno di 400 ms, e il 27% più economico.
P90 latency
Cost per 1,000 calls
Perché questa PR che abbiamo inviato è stata chiusa?
I nostri agenti inviano pull request agli sviluppatori, e una delle nostre metriche chiave di successo è il tasso di merge. Dobbiamo capire perché le pull request vengono chiuse per poter migliorare il prodotto.
Quando una nostra PR viene chiusa senza merge, l’agente legge le review, la discussione e i riferimenti ad altro lavoro, quindi sceglie il motivo: il fix era sbagliato, un umano l’ha risolta in un altro modo, l’issue era un falso positivo, la PR è diventata obsoleta, oppure il comportamento era voluto.
Passando a Jev per questo caso d’uso, abbiamo migliorato la latenza fino a 6 volte più veloce al P90, ma solo il 17% più economico.
P90 latency
Cost per 1,000 calls
Quanto è urgente questa pull request?
Prima di inviare una pull request agli sviluppatori, i nostri agenti devono classificarla in modo che le cose con severità più alta salgano in cima. Per questa classificazione, l’agente valuta il problema sottostante su una scala che va da critico a info. Valuta l’impatto attuale, non il rischio ipotetico.
P90 latency
Cost per 1,000 calls
Passare a Jev qui ha ridotto sostanzialmente i costi: il 59% più economico rispetto a DeepSeek V4.1 Flash, e quasi 5 volte più veloce al P90.
Jev è più veloce su ogni classificazione. Dove ha sostituito GPT-OSS 120B, il guadagno riguarda soprattutto la latenza. Dove ha sostituito DeepSeek V4.1 Flash, ha anche tagliato la spesa di più della metà.
Caso d’uso 3: ranking, ovvero quanto è importante questa risorsa cloud?
Per ottenere il massimo da Polylane, i team collegano i propri account cloud. Creiamo un context graph di tutte le risorse cloud, in modo che gli agenti possano capire rapidamente la relazione tra nodi di calcolo, database, code, eccetera.
Sulla piattaforma abbiamo team con account cloud estremamente carichi, con decine di migliaia di nodi. Ogni server, sandbox, database e coda è un nodo nel nostro context graph. È necessario classificare ciascuno di questi nodi in modo che gli agenti sappiano cosa è critico per la tua applicazione e cosa può sostanzialmente “permettersi” di fallire.
Assegniamo a ogni risorsa uno di quattro tier di priorità: Critical, Standard, Low o Minimal.
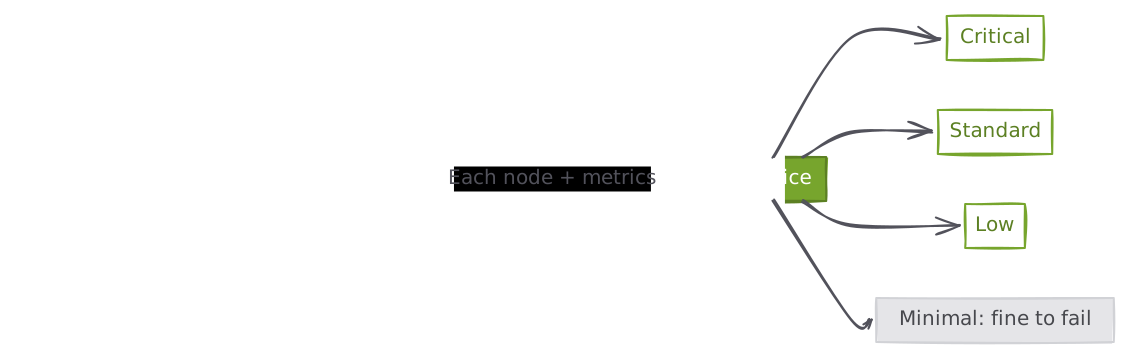
Jev valuta una domanda Choice per ciascuna risorsa, con un contesto basato su configurazione, ambiente, metriche recenti e dipendenze.
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
Il ranking è dove Jev dà il meglio di sé: più di 10 volte più veloce al P90, passando da 5.4 secondi a circa mezzo secondo, e il 34% più economico. È anche la nostra decisione a volume più alto, quindi guida la maggior parte del risparmio complessivo.
P90 latency
Cost per 1,000 calls
Riepilogo
Nel complesso, Jev ha portato riduzioni sostanziali in latenza e costo stimato ogni 1.000 chiamate:
- riduzione della latenza P90: 4,752 ms —> 508 ms.
- riduzione del costo ogni 1.000 chiamate: $0.76199 —> $0.46369.
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is betterPer modello, Jev è sia il più veloce che il più economico: leggermente più economico di DeepSeek V4.1 Flash, e ben al di sotto di entrambi i modelli GPT-OSS.
Swipe to see every point.
Ovunque i nostri agenti scelgano tra un insieme fisso di risposte, Jev è ora la scelta predefinita: è più veloce ed economico su ogni decisione che abbiamo spostato.