

LLMをJevに置き換えました。コストは39%削減されました。
Explore with AI
私たちは、常時稼働するオンコールエージェントを構築しています。このエージェントは常に判断を下しています。例えば:
- このイシューはどれくらい深刻か
- このSlackスレッドに能動的に関与すべきか
- このインシデントは以前にも見たことがあるか
先週まで、これらのタスクにはLLMを使用していました。今週Jevにアクセスできるようになるとすぐに、試験運用を始めました。
Jevとは
JevはTypeSafe AIによる判断モデルです。テキストは生成せず、型付きの値とキャリブレーションされた確率でデータに関する質問に答えます。TypeSafeはこれを「賢いif文」として位置付けており、手書きのロジックでは脆くなりがちな分類、ルーティング、スコアリングの各ステップ向けだとしています。1回の応答は70から500msで、出力トークンは無料だとしています。私たちのエージェントはこうした判断を一日中行っているため、本番環境に導入しました。
仕組み
リクエストは2つの部分から成ります。判断してほしいテキストやJSONであるstateと、答えてほしいquestionsです。各質問は次の3種類のいずれかです:
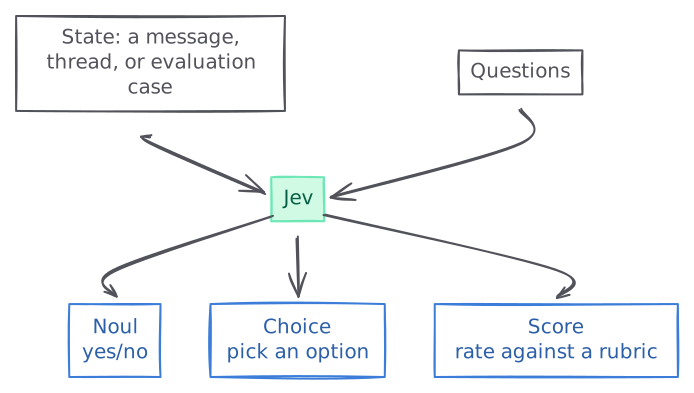
- Noulは
yesである確率を返します。 - Choiceは提示された選択肢の中から1つを選びます。
- Scoreは順序付けられたルーブリックに対する確率加重値を返します。
ユースケース1: ルーティング、つまりエージェントはいつ応答すべきか
私たちのエージェントはSlackとGithub上で能動的に動きます。ユーザーに提供できる有意義な知見があれば、Slackメッセージやgithubのコメントに応答します。エージェントはユーザーが求めたときに行動する必要がありますが、あらゆるイベントに過剰反応してはいけません。これはJevのNoul質問にとって最適なユースケースです。
- エージェントが提出したPRへのコメント: レビュアーが変更を求めるとエージェントは起動します。CIのステータス更新や「ありがとう」といったコメントでは起動しません。
- Slackチャンネル: インフラに関する直接的な質問など、明らかに役立てる場合に限り、エージェントは招かれなくても発言します。人間同士の調整には関与しません。
- エージェントが参加しているSlackスレッド: 自分宛のメッセージには応答し、人間同士の会話は無視し、退出を求められたら退出します。
以下は、エージェントがSlackメッセージにフォローアップすべきかどうかを判断するJevリクエストの例です。
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
Jevを約1週間運用し、このタスクで以前使用していたLLMと比較しました。
P90 latency
Cost per 1,000 calls
ルーティングはP90で3倍高速化し、1.5秒から500ms未満になりました。コストもほぼ半減しています。
ユースケース2: 分類、つまり証拠は何を意味するか
エージェントが物事を異なるバケットに分類する必要があるタスクもいくつか実行しています。例えば、提示された証拠に基づいて、エージェントはこのイシューの調査を開始すべきか、既存のイシューに関連するものとして畳み込むべきか、あるいは以前に解決済みのイシューの重複なのか、といった判断です。
JevのChoice質問は、その証拠を私たちが定義した基準に基づく1つのラベルに変換し、次のステップはそのラベルによって決まります。次のようになります:
この方法で3つの分類を実行しています。それぞれが明示的な基準を持つChoice質問を使用しており、それぞれが異なるLLMを置き換えたため、個別に計測しました。
これらのインシデントは関連しているか
新しいインシデントが発生すると、エージェントはそれを既存のインシデントと比較します。根本原因が同一なのか、関連しているのか、それとも独立しているのか、といった具合です。この例では候補を1件だけ示していますが、本番の呼び出しでは同じ新規インシデントに対して複数の候補を比較します。
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
このユースケースでJevに切り替えたことで、P90でほぼ8倍高速化し、2.9秒から400ms未満になり、コストも27%削減されました。
P90 latency
Cost per 1,000 calls
提出したこのPRはなぜクローズされたのか
私たちのエージェントは開発者にプルリクエストを提出しており、主要な成功指標の1つがマージ率です。プロダクトを改善するためには、プルリクエストがクローズされる理由を理解する必要があります。
私たちのPRがマージされずにクローズされると、エージェントはレビュー、議論、他の作業への参照を読み取り、理由を選びます。修正が誤っていた、人間が別の方法で修正した、イシューが偽陽性だった、PRが放置されて古くなった、あるいはその挙動は意図されたものだった、のいずれかです。
このユースケースでJevに切り替えたことで、P90のレイテンシーは6倍高速化しましたが、コストは17%の削減にとどまりました。
P90 latency
Cost per 1,000 calls
このプルリクエストはどれほど緊急か
開発者にプルリクエストを提出する前に、私たちのエージェントは深刻度の高いものが上位に来るようにランク付けする必要があります。この分類では、エージェントは根本的な問題をcriticalからinfoまでの段階で評価します。評価するのは仮定上のリスクではなく、現在の影響です。
P90 latency
Cost per 1,000 calls
ここでJevに切り替えたことで、コストは大幅に削減されました。DeepSeek V4.1 Flashと比べて59%安く、P90ではほぼ5倍高速です。
Jevはすべての分類において高速です。GPT-OSS 120Bを置き換えた箇所では、主にレイテンシーの改善が得られました。DeepSeek V4.1 Flashを置き換えた箇所では、コストも半分以上削減されました。
ユースケース3: ランキング、つまりこのクラウドリソースはどれほど重要か
Polylaneを最大限活用するために、チームはクラウドアカウントを接続します。私たちはすべてのクラウドリソースのコンテキストグラフを作成し、エージェントがコンピュートノード、データベース、キューなどの間の関係性を素早く理解できるようにしています。
プラットフォーム上には、数万ノード規模の極めて多忙なクラウドアカウントを持つチームもあります。各サーバー、サンドボックス、データベース、キューは、私たちのコンテキストグラフにおける1つのノードです。エージェントがアプリケーションにとって何が重要で、何が実質的に「壊れても問題ない」ものかを把握できるように、これらのノードそれぞれをランク付けする必要があります。
各リソースには、Critical、Standard、Low、Minimalの4段階の優先度ティアのいずれかを割り当てます。
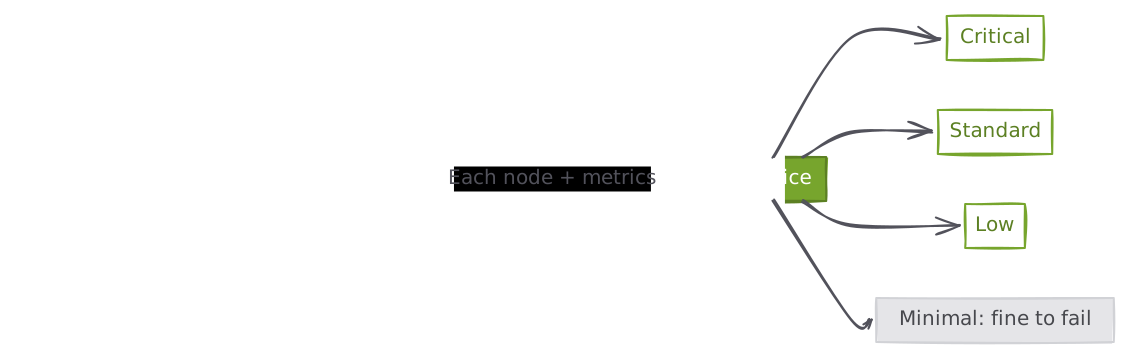
Jevは、設定、環境、直近のメトリクス、依存関係に基づくコンテキストとともに、各リソースについてChoice質問を評価します。
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
ランキングはJevが最も輝く領域です。P90で10倍以上高速化し、5.4秒から約0.5秒になり、コストも34%削減されました。これは最も呼び出し回数が多い判断でもあるため、全体の削減効果の大部分を牽引しています。
P90 latency
Cost per 1,000 calls
まとめ
全体として、Jevは1,000件あたりのレイテンシーと推定コストの両方で大幅な削減を実現しました:
- P90レイテンシーの削減: 4,752ms —> 508ms
- 1,000件あたりのコストの削減: $0.76199 —> $0.46369
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is betterモデルごとに見ると、Jevは最速かつ最安です。DeepSeek V4.1 Flashよりもわずかに安く、両方のGPT-OSSモデルを大きく下回っています。
Swipe to see every point.
エージェントが固定された選択肢の中から選ぶ場面では、Jevが今や既定の選択肢です。移行したすべての判断において、より高速で安価になりました。