

我們把 LLM 換成了 Jev,成本降低 39%。
Explore with AI
我們正在打造一個全天候的值班代理,它會不斷做出決策,例如:
- 這個問題有多嚴重?
- 我們該不該在這個 Slack 對話串主動出擊?
- 我們之前看過這個事件嗎?
到上週為止,我們都用 LLM 來處理這些工作。這週一拿到 Jev 的存取權,我們就開始試用它。
Jev 是什麼?
Jev 是來自 TypeSafe AI 的決策模型。它不會生成文字,而是用具型別的數值與經過校準的機率來回答關於你資料的問題。TypeSafe 把它定位為「智慧 if 陳述式」,也就是分類、路由與評分這類手寫邏輯太脆弱的步驟,並宣稱每次回應只要 70 到 500 毫秒,且輸出 token 免費。我們的代理整天都在做這類決策,所以我們把它上線到生產環境。
運作方式
一個請求有兩個部分:state,也就是你想針對其做出決策的文字或 JSON;以及你想要得到答案的 questions。每個問題屬於下列三種類型之一:
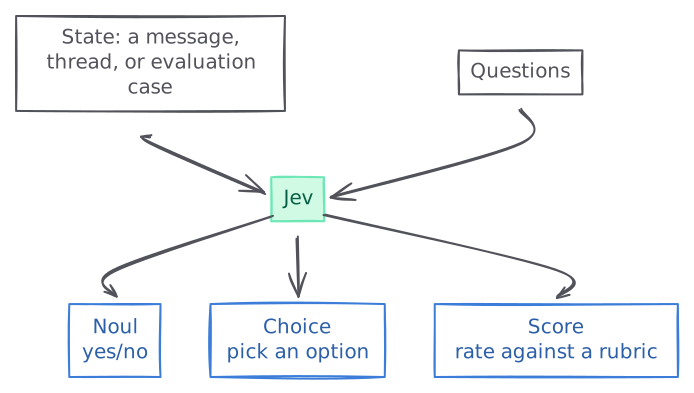
- Noul 回傳
yes的機率。 - Choice 從提供的選項中選出一個。
- Score 依照有序的評分標準,回傳機率加權後的數值。
使用情境 1:路由,也就是代理什麼時候該回應?
我們的代理會在 Slack 與 Github 上主動出擊。只要對使用者有值得提供的見解,代理就會回覆 Slack 訊息或 Github 留言。代理需要在使用者提出要求時採取行動,但不能對每個事件都反應過度。這正是 Jev 的 Noul 問題最適合發揮的使用情境。
- 代理提交的 PR 上的留言: 審查者要求修改時會叫醒代理。CI 狀態更新或一句「謝謝」則不會。
- Slack 頻道: 只有在明顯能幫上忙時,例如直接的基礎架構問題,代理才會主動插話。人類彼此協調時,代理不會介入。
- 代理所在的 Slack 對話串: 代理會回答針對它的訊息,忽略人類之間的對話,並在有人要求時離開。
以下是一個 Jev 請求的範例,用來判斷代理是否該追蹤某則 Slack 訊息。
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
我們讓 Jev 執行了大約一週,並與先前用於這項任務的 LLM 做比較。
P90 latency
Cost per 1,000 calls
路由的 P90 延遲快了 3 倍,從 1.5 秒降到 500 毫秒以下,成本則減少了將近一半。
使用情境 2:分類,也就是證據代表什麼意思?
我們還執行了幾項任務,需要代理把事物分類到不同的類別中。舉例來說,根據提供的證據,代理應該開始調查這個問題,應該把它併入既有的相關問題,還是它其實是先前已解決問題的重複項目?
一個 Jev 的 Choice 問題會依照我們定義的準則,把這些證據轉換成一個標籤,接著由這個標籤決定下一步。運作方式如下:
我們用這種方式執行三種分類。每一種都使用帶有明確準則的 Choice 問題,並各自取代了不同的 LLM,因此我們分開測量它們。
這些事件彼此相關嗎?
當一個新事件開啟時,代理會將它與既有事件比較:它們是否共用同一個根本原因、是否相關,還是彼此獨立?這個示意範例只展示一個候選項目,實際生產環境中的呼叫會針對同一個新事件比較多個候選項目。
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
把這個使用情境換成 Jev 之後,P90 延遲快了將近 8 倍,從 2.9 秒降到 400 毫秒以下,成本也便宜了 27%。
P90 latency
Cost per 1,000 calls
我們提交的這個 PR 為什麼被關閉?
我們的代理會向開發者提交 pull request,而合併率是我們的關鍵成功指標之一。我們需要了解 pull request 被關閉的原因,才能改進產品。
當我們的某個 PR 未經合併就被關閉時,代理會閱讀審查意見、討論內容,以及對其他工作的參照,接著挑出原因:修正方式錯誤、人類用其他方式修好了、問題是誤報、PR 逾期未處理,或者該行為原本就是預期中的。
把這個使用情境換成 Jev 之後,P90 延遲快了 6 倍,但成本只便宜了 17%。
P90 latency
Cost per 1,000 calls
這個 pull request 有多急迫?
在向開發者提交 pull request 之前,我們的代理需要為它排序,讓嚴重程度較高的項目排到前面。針對這項分類,代理會依照從 critical 到 info 的等級,為背後的問題評分。它評的是目前的影響,而不是假設性的風險。
P90 latency
Cost per 1,000 calls
在這裡換成 Jev 大幅降低了成本:比 DeepSeek V4.1 Flash 便宜 59%,P90 延遲也快了將近 5 倍。
Jev 在每一種分類上都更快。在取代 GPT-OSS 120B 的地方,主要的好處在於延遲;在取代 DeepSeek V4.1 Flash 的地方,帳單也砍掉了超過一半。
使用情境 3:排序,也就是這個雲端資源有多重要?
為了充分發揮 Polylane 的效果,團隊會連接他們的雲端帳戶。我們會為所有雲端資源建立一個情境圖,讓代理能快速理解運算節點、資料庫、佇列等資源之間的關係。
平台上有些團隊的雲端帳戶非常繁忙,節點數多達數萬個。每一台伺服器、沙箱、資料庫和佇列都是我們情境圖中的一個節點。我們必須為這些節點排序,讓代理知道什麼對你的應用程式而言是關鍵,什麼基本上「壞了也沒關係」。
我們為每個資源分配四個優先層級之一:Critical、Standard、Low 或 Minimal。
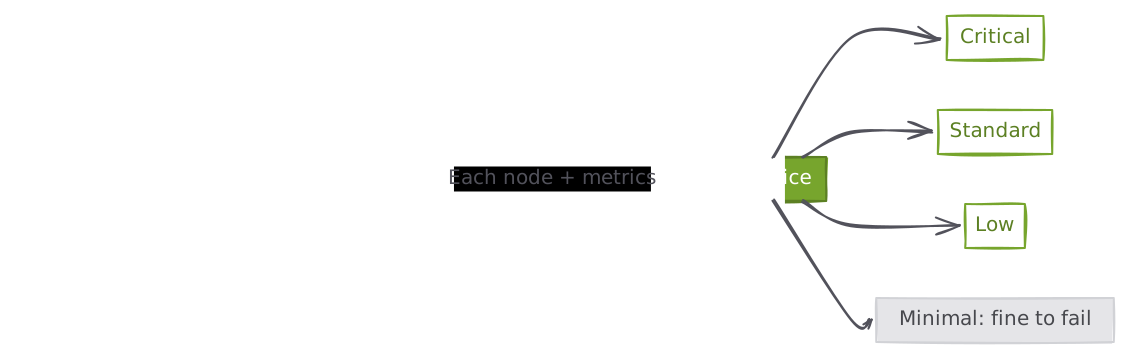
Jev 會針對每個資源評估一個 Choice 問題,並根據設定、環境、近期指標與相依關係提供情境資訊。
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
排序正是 Jev 大放異彩之處:P90 延遲快了超過 10 倍,從 5.4 秒降到大約半秒,成本也便宜了 34%。這也是我們量體最大的決策,因此貢獻了整體節省的大部分。
P90 latency
Cost per 1,000 calls
總結
整體而言,Jev 大幅降低了延遲與每 1,000 次呼叫的估計成本:
- P90 延遲降低:4,752 毫秒 —> 508 毫秒。
- 每 1,000 次呼叫成本降低:$0.76199 —> $0.46369。
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is better以個別模型來看,Jev 既是最快也是最便宜的:比 DeepSeek V4.1 Flash 稍微便宜,並且遠低於兩款 GPT-OSS 模型。
Swipe to see every point.
只要我們的代理是從固定的一組答案中做選擇,Jev 現在就是預設選項:在我們移轉過去的每一個決策上,它都更快也更便宜。