

Cambiamos nuestros LLMs por Jev. Es un 39% más barato.
Explore with AI
Estamos construyendo un agente de guardia siempre activo, que toma decisiones constantemente, por ejemplo:
- ¿qué tan grave es este issue?
- ¿deberíamos ser proactivos en este hilo de slack?
- ¿hemos visto este incidente antes?
Hasta la semana pasada, veníamos usando LLMs para estas tareas. En cuanto tuvimos acceso a Jev esta semana, empezamos a experimentar con él.
¿qué es Jev?
Jev es un modelo de decisión de TypeSafe AI. No genera texto: responde preguntas sobre tus datos con valores tipados y probabilidades calibradas. TypeSafe lo presenta como “sentencias if inteligentes”, los pasos de clasificar, enrutar y puntuar donde la lógica escrita a mano resulta demasiado frágil, y cita entre 70 y 500 ms por respuesta con tokens de salida gratuitos. Nuestros agentes toman esas decisiones todo el día, así que lo pusimos en producción.
cómo funciona
Una solicitud tiene dos partes: el state, que es el texto o JSON sobre el que quieres una decisión, y las questions que quieres que responda. Cada pregunta tiene uno de tres tipos:
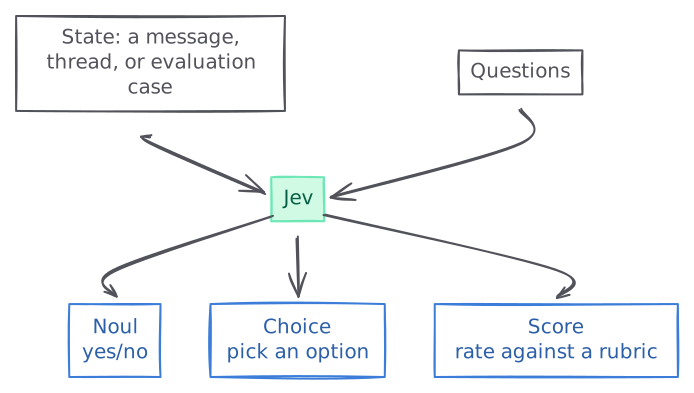
- Noul devuelve la probabilidad de
yes. - Choice selecciona una de las opciones proporcionadas.
- Score devuelve un valor ponderado por probabilidad a lo largo de una rúbrica ordenada.
caso de uso 1: enrutamiento, o ¿cuándo debería responder el agente?
Nuestros agentes son proactivos en Slack y Github. Responden a mensajes de Slack o comentarios de Github si tienen una idea relevante que aportar al usuario. Los agentes necesitan actuar cuando un usuario lo solicita, sin reaccionar de más a cada evento. Este es un caso de uso perfecto para las preguntas Noul de Jev.
- Comentarios en PRs que nuestros agentes enviaron: un revisor que pide un cambio despierta al agente. Una actualización de estado de CI o un “gracias” no lo hace.
- Canales de Slack: el agente interviene sin ser invitado solo cuando puede ayudar claramente, como ante una pregunta directa de infraestructura. Se mantiene al margen cuando humanos se coordinan entre sí.
- Hilos de Slack en los que participa el agente: responde a los mensajes dirigidos a él, ignora a los humanos que hablan entre sí, y se retira cuando alguien se lo pide.
Aquí tienes un ejemplo de una solicitud a Jev para determinar si un agente debería dar seguimiento a un mensaje de Slack.
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
Ejecutamos Jev durante aproximadamente una semana y lo comparamos con el LLM que usábamos antes para esta tarea.
P90 latency
Cost per 1,000 calls
El enrutamiento se volvió 3 veces más rápido en P90, de 1.5 segundos a menos de 500 ms, y el costo cayó casi a la mitad.
caso de uso 2: clasificación, o ¿qué significa la evidencia?
También ejecutamos algunas tareas donde el agente necesita clasificar cosas en diferentes categorías. Por ejemplo, según la evidencia proporcionada, ¿debería el agente empezar a investigar el issue, debería agruparlo como relacionado con un issue existente, o es un duplicado de un issue ya resuelto?
Una pregunta Choice de Jev convierte esa evidencia en una etiqueta a partir de criterios que definimos, y el siguiente paso se decide según esa etiqueta. Se ve así:
Ejecutamos tres clasificaciones de esta manera. Cada una usa una pregunta Choice con criterios explícitos, y cada una reemplazó a un LLM distinto, así que las medimos por separado.
¿están relacionados estos incidentes?
Cuando se abre un nuevo incidente, el agente lo compara con incidentes existentes: ¿comparten una misma causa raíz, están relacionados, o son independientes? Este ejemplo ilustrativo muestra un candidato; una llamada en producción compara varios contra el mismo incidente nuevo.
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
Al cambiar a Jev para este caso de uso, lo hicimos casi 8 veces más rápido en P90, de 2.9 segundos a menos de 400 ms, y un 27% más barato.
P90 latency
Cost per 1,000 calls
¿por qué se cerró este PR que enviamos?
Nuestros agentes envían pull requests a los desarrolladores, y una de nuestras métricas clave de éxito es la tasa de merge. Necesitamos entender por qué se cierran los pull requests para poder mejorar el producto.
Cuando uno de nuestros PRs se cierra sin hacer merge, el agente lee las revisiones, la discusión y las referencias a otro trabajo, y luego elige el motivo: el arreglo era incorrecto, un humano lo arregló de otra manera, el issue era un falso positivo, el PR quedó obsoleto, o el comportamiento era intencional.
Al cambiar a Jev para este caso de uso, mejoramos la latencia 6 veces en P90, pero solo un 17% más barato.
P90 latency
Cost per 1,000 calls
¿qué tan urgente es este pull request?
Antes de enviar un pull request a los desarrolladores, nuestros agentes necesitan clasificarlo para que las cosas de mayor severidad suban al principio. Para esta clasificación, el agente califica el problema subyacente en una escala de crítico a info. Califica el impacto actual, no el riesgo hipotético.
P90 latency
Cost per 1,000 calls
Cambiar a Jev aquí redujo sustancialmente el costo: un 59% más barato que DeepSeek V4.1 Flash, y casi 5 veces más rápido en P90.
Jev es más rápido en cada clasificación. Donde reemplazó a GPT-OSS 120B, la ganancia es sobre todo de latencia. Donde reemplazó a DeepSeek V4.1 Flash, también redujo la factura a más de la mitad.
caso de uso 3: clasificación, o ¿qué tan importante es este recurso de nube?
Para aprovechar al máximo Polylane, los equipos conectan sus cuentas de nube. Creamos un context graph de todos los recursos de nube, para que los agentes puedan entender rápidamente la relación entre nodos de cómputo, bases de datos, colas, etc.
Tenemos equipos en la plataforma con cuentas de nube extremadamente activas, con decenas de miles de nodos. Cada servidor, sandbox, base de datos y cola es un nodo en nuestro context graph. Es necesario clasificar cada uno de estos nodos para que los agentes sepan qué es crítico para tu aplicación, y qué es básicamente “aceptable” que falle.
Asignamos uno de cuatro niveles de prioridad a cada recurso: Crítico, Estándar, Bajo o Mínimo.
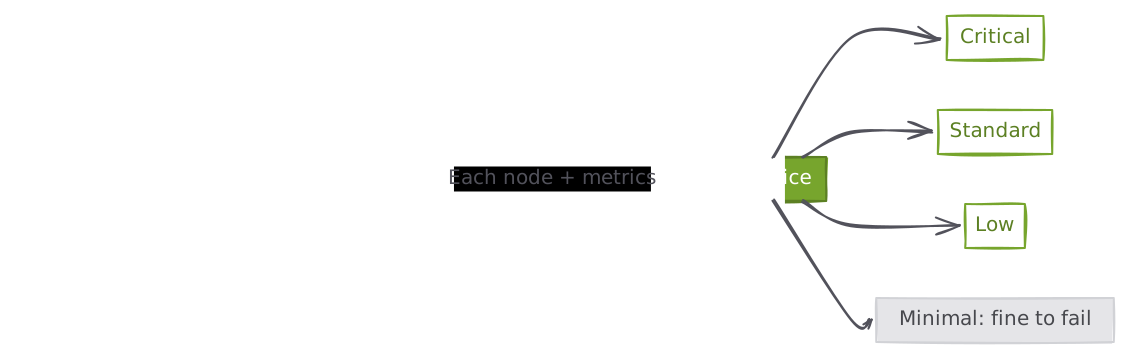
Jev evalúa una pregunta Choice para cada recurso, con contexto basado en la configuración, el entorno, las métricas recientes y las dependencias.
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
La clasificación es donde Jev brilla: más de 10 veces más rápido en P90, de 5.4 segundos a cerca de medio segundo, y un 34% más barato. También es nuestra decisión de mayor volumen, así que es la que más impulsa el ahorro total.
P90 latency
Cost per 1,000 calls
resumen
En general, Jev logró reducciones generales sustanciales en la latencia y en el costo estimado por 1,000 llamadas:
- Reducción de latencia P90: 4,752 ms —> 508 ms.
- Reducción del costo por 1,000 llamadas: $0.76199 —> $0.46369.
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is betterPor modelo, Jev es a la vez el más rápido y el más barato: un poco más barato que DeepSeek V4.1 Flash, y muy por debajo de ambos modelos GPT-OSS.
Swipe to see every point.
En cualquier lugar donde nuestros agentes eligen entre un conjunto fijo de respuestas, Jev es ahora la opción por defecto: es más rápido y más barato en cada decisión que migramos.