

我们把LLM换成了Jev,成本降低了39%。
Explore with AI
我们在打造一个始终在线的on-call智能体,它需要不断做出决策,例如:
- 这个问题有多严重?
- 我们应该在这条Slack线程中主动介入吗?
- 我们之前见过这个故障吗?
直到上周,我们一直用LLM来处理这些任务。这周一拿到Jev的访问权限,我们就开始试用了。
Jev是什么?
Jev是一个来自TypeSafe AI的决策模型。它不生成文本:它用带类型的值和经过校准的概率,来回答关于你的数据的问题。TypeSafe把它定位为”智能if语句”,用于分类、路由和打分这类手写逻辑过于脆弱的环节,并宣称每次响应耗时70到500毫秒,且输出token免费。我们的智能体整天都在做这类决策,于是我们把它上线到了生产环境。
工作原理
一个请求由两部分组成:state,也就是你想要就此做出决策的文本或JSON;以及你想要得到答案的questions。每个问题都属于以下三种类型之一:
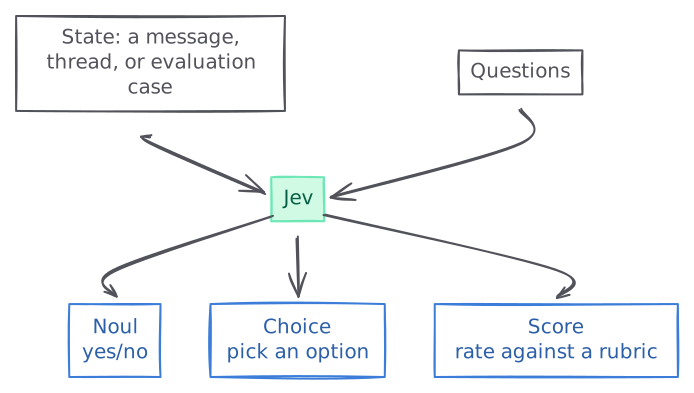
- Noul返回
yes的概率。 - Choice从给定的选项中选出一个。
- Score在一个有序的评分标准上返回一个按概率加权的值。
使用场景一:路由,也就是智能体什么时候该出手?
我们的智能体会在Slack和Github上主动介入。如果它们能为用户提供有意义的见解,就会回复Slack消息或Github评论。智能体需要在用户提出请求时采取行动,同时又不能对每个事件都反应过度。这正是Jev的Noul问题的理想用武之地。
- 对我们智能体提交的PR的评论: 审查者要求修改会唤醒智能体,而CI状态更新或一句”谢谢”则不会。
- Slack频道: 只有在能明确提供帮助时,智能体才会不请自来地插话,比如一个直接的基础设施问题。如果只是人类之间在互相协调,它就不会介入。
- 智能体所在的Slack线程: 它会回复对自己的消息,忽略人类之间的对话,并在有人要求它离开时退出。
下面是一个Jev请求的示例,用于判断智能体是否应该跟进一条Slack消息。
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
我们运行了Jev大约一周,并与此前用于这项任务的LLM做了对比。
P90 latency
Cost per 1,000 calls
路由速度在P90上快了3倍,从1.5秒降到500毫秒以内,成本也降低了将近一半。
使用场景二:分类,也就是证据意味着什么?
我们还运行了几项需要把事物分到不同类别中的任务。例如,根据现有证据,智能体是应该开始调查这个问题,把它归并为与某个已有问题相关,还是判定它是此前已解决问题的重复?
Jev的Choice问题会把这些证据转化为我们定义好的判断标准中的一个标签,下一步该做什么由这个标签决定。大致如下:
我们用这种方式运行了三类分类任务。每一类都使用一个带有明确判断标准的Choice问题,而且各自取代了不同的LLM,所以我们对它们分别做了测量。
这些故障之间有关联吗?
当一个新故障出现时,智能体会把它与现有故障进行比较:它们是否共享同一个根因,是否相关,还是彼此独立?下面这个示例只展示了一个候选项;实际生产调用会把同一个新故障与多个候选项进行比较。
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
在这个场景中切换到Jev之后,P90延迟快了近8倍,从2.9秒降到400毫秒以内,成本也降低了27%。
P90 latency
Cost per 1,000 calls
我们提交的这个PR为什么被关闭了?
我们的智能体会向开发者提交拉取请求,而合并率是我们最关键的成功指标之一。我们需要弄清楚拉取请求被关闭的原因,这样才能持续改进产品。
当我们提交的某个PR被关闭而没有合并时,智能体会阅读审查意见、讨论内容以及对其他工作的引用,然后从中判断原因:修复方案是错的、有人用其他方式修复了问题、这个问题原本就是误报、PR搁置太久,还是原本的行为就是预期的。
在这个场景中切换到Jev之后,P90延迟提升到快了6倍,但成本只降低了17%。
P90 latency
Cost per 1,000 calls
这个拉取请求有多紧急?
在向开发者提交拉取请求之前,我们的智能体需要对其进行排序,让更高严重程度的问题排在前面。在这项分类任务中,智能体会把底层问题按从”critical”到”info”的等级进行评定,评的是当前的实际影响,而不是假设性的风险。
P90 latency
Cost per 1,000 calls
在这一场景中切换到Jev大幅降低了成本:比DeepSeek V4.1 Flash便宜59%,P90延迟也快了近5倍。
Jev在每一类分类任务上都更快。在它取代GPT-OSS 120B的场景中,主要收益体现在延迟上;在它取代DeepSeek V4.1 Flash的场景中,账单也降低了超过一半。
使用场景三:排序,也就是这个云资源有多重要?
为了充分发挥Polylane的作用,团队会连接自己的云账户。我们会为所有云资源构建一张上下文图,让智能体能够快速理解计算节点、数据库、队列等之间的关系。
平台上有些团队的云账户极其繁忙,节点数量多达数万个。每一台服务器、每一个沙箱、数据库和队列,都是我们上下文图中的一个节点。我们必须对这些节点逐一排序,这样智能体才能知道哪些对你的应用来说至关重要,哪些基本上”坏了也无妨”。
我们会为每个资源分配以下四个优先级层级之一:Critical、Standard、Low或Minimal。
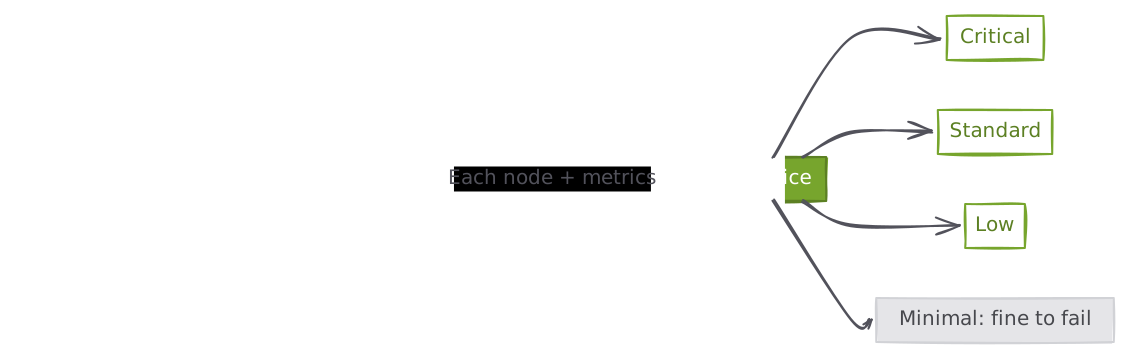
Jev会针对每个资源评估一个Choice问题,上下文基于配置、环境、近期指标以及依赖关系。
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
排序正是Jev大放异彩的地方:P90延迟快了10倍以上,从5.4秒降到约0.5秒,成本降低了34%。这也是我们调用量最大的决策,因此它贡献了整体节省中的大部分。
P90 latency
Cost per 1,000 calls
总结
总体而言,Jev大幅降低了每1,000次调用的延迟和预估成本:
- P90延迟降低:4,752毫秒 —> 508毫秒。
- 每1,000次调用成本降低:$0.76199 —> $0.46369。
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is better按模型来看,Jev既是最快的,也是最便宜的:略低于DeepSeek V4.1 Flash,并且远低于两款GPT-OSS模型。
Swipe to see every point.
只要我们的智能体是从一组固定答案中做选择,Jev现在就是默认选择:在我们迁移过的每一项决策上,它都更快、更便宜。