

Trocamos nossos LLMs pelo Jev. Ficou 39% mais barato.
Explore with AI
Estamos construindo um agente de plantão sempre ativo, que toma decisões constantemente, por exemplo:
- qual é a gravidade dessa issue?
- devemos ser pró-ativos nessa thread do Slack?
- já vimos esse incidente antes?
Até a semana passada, estávamos usando LLMs para essas tarefas. Assim que tivemos acesso ao Jev essa semana, começamos a testá-lo.
O que é o Jev?
O Jev é um modelo de decisão da TypeSafe AI. Ele não gera texto: responde a perguntas sobre seus dados com valores tipados e probabilidades calibradas. A TypeSafe o promove para “if-statements inteligentes”, as etapas de classificar, rotear e pontuar em que a lógica escrita à mão é frágil demais, e cita de 70 a 500 ms por resposta com tokens de saída gratuitos. Nossos agentes tomam essas decisões o dia todo, então colocamos o Jev em produção.
Como funciona
Uma requisição tem duas partes: o state, que é o texto ou JSON sobre o qual você quer uma decisão, e as questions que você quer que sejam respondidas. Cada pergunta tem um de três tipos:
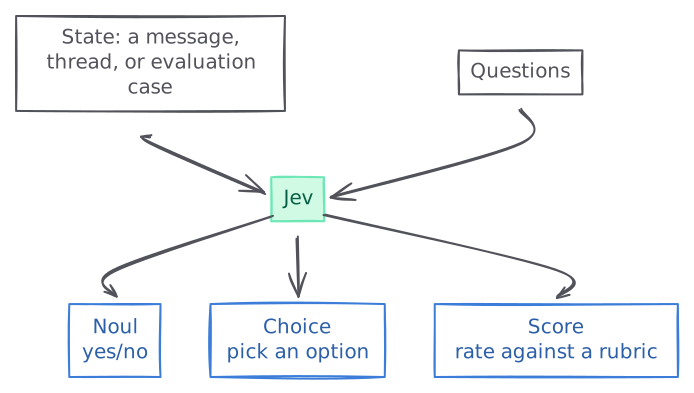
- Noul retorna a probabilidade de
yes. - Choice seleciona uma das opções fornecidas.
- Score retorna um valor ponderado por probabilidade em uma rubrica ordenada.
Caso de uso 1: roteamento, ou quando o agente deve responder?
Nossos agentes são pró-ativos no Slack e no Github. Eles respondem a mensagens do Slack ou comentários do Github se tiverem um insight relevante para oferecer ao usuário. Os agentes precisam agir quando um usuário solicita, sem reagir exageradamente a cada evento. Esse é um caso de uso perfeito para as perguntas Noul do Jev.
- Comentários em PRs enviadas pelos nossos agentes: um revisor pedindo uma mudança acorda o agente. Uma atualização de status de CI ou um “obrigado” não.
- Canais do Slack: o agente entra sem ser convidado só quando pode ajudar claramente, como em uma pergunta direta sobre infraestrutura. Ele fica de fora quando humanos estão se coordenando entre si.
- Threads do Slack em que o agente está: ele responde a mensagens destinadas a ele, ignora humanos conversando entre si, e sai quando alguém pede.
Aqui está um exemplo de requisição ao Jev para determinar se um agente deve dar seguimento a uma mensagem do Slack.
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}
Rodamos o Jev por cerca de uma semana e comparamos com o LLM que usávamos antes para essa tarefa.
P90 latency
Cost per 1,000 calls
O roteamento ficou 3x mais rápido no P90, de 1.5 segundos para menos de 500 ms, e o custo caiu quase pela metade.
Caso de uso 2: classificação, ou o que a evidência significa?
Também executamos algumas tarefas em que o agente precisa classificar coisas em diferentes categorias. Por exemplo, com base na evidência fornecida, o agente deve começar a investigar a issue, deve dobrá-la em uma issue existente relacionada, ou ela é uma duplicata de uma issue resolvida anteriormente?
Uma pergunta Choice do Jev transforma essa evidência em um rótulo a partir de critérios que definimos, e o próximo passo é decidido pelo rótulo. Funciona assim:
Executamos três classificações dessa forma. Cada uma usa uma pergunta Choice com critérios explícitos, e cada uma substituiu um LLM diferente, então medimos cada uma separadamente.
Esses incidentes estão relacionados?
Quando um novo incidente é aberto, o agente o compara com incidentes existentes: eles compartilham a mesma causa raiz, estão relacionados, ou são independentes? Este exemplo ilustrativo mostra um candidato; uma chamada em produção compara vários candidatos com o mesmo novo incidente.
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
Ao trocar para o Jev nesse caso de uso, deixamos isso quase 8x mais rápido no P90, de 2.9 segundos para menos de 400 ms, e 27% mais barato.
P90 latency
Cost per 1,000 calls
Por que essa PR que enviamos foi fechada?
Nossos agentes enviam pull requests para desenvolvedores, e uma das nossas principais métricas de sucesso é a taxa de merge. Precisamos entender por que as pull requests são fechadas para conseguirmos melhorar o produto.
Quando uma das nossas PRs é fechada sem passar pelo merge, o agente lê as revisões, a discussão e referências a outros trabalhos, e então escolhe o motivo: a correção estava errada, um humano corrigiu de outra forma, a issue era um falso positivo, a PR ficou obsoleta, ou o comportamento era intencional.
Ao trocar para o Jev nesse caso de uso, melhoramos a latência para 6x mais rápida no P90, mas apenas 17% mais barato.
P90 latency
Cost per 1,000 calls
Quão urgente é essa pull request?
Antes de enviar uma pull request para desenvolvedores, nossos agentes precisam classificá-la de modo que as questões de maior gravidade subam ao topo. Para essa classificação, o agente avalia o problema subjacente em uma escala de crítico a informativo. Ele avalia o impacto atual, não o risco hipotético.
P90 latency
Cost per 1,000 calls
Trocar para o Jev aqui reduziu o custo substancialmente: 59% mais barato que o DeepSeek V4.1 Flash, e quase 5x mais rápido no P90.
O Jev é mais rápido em todas as classificações. Onde substituiu o GPT-OSS 120B, o ganho é principalmente de latência. Onde substituiu o DeepSeek V4.1 Flash, também cortou a conta pela metade.
Caso de uso 3: priorização, ou qual a importância desse recurso de nuvem?
Para aproveitar ao máximo o Polylane, os times conectam suas contas de nuvem. Criamos um grafo de contexto de todos os recursos de nuvem, para que os agentes possam entender rapidamente a relação entre nós de computação, bancos de dados, filas etc.
Temos times na plataforma com contas de nuvem extremamente movimentadas, com dezenas de milhares de nós. Cada servidor, sandbox, banco de dados e fila é um nó no nosso grafo de contexto. É necessário priorizar cada um desses nós para que os agentes saibam o que é crítico para sua aplicação, e o que essencialmente “pode falhar sem problema”.
Atribuímos um de quatro níveis de prioridade a cada recurso: Critical, Standard, Low ou Minimal.
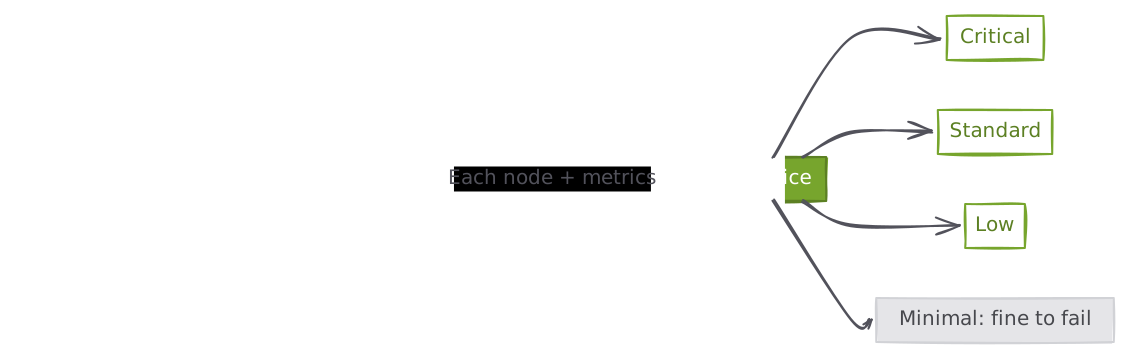
O Jev avalia uma pergunta Choice para cada recurso, com contexto baseado em configuração, ambiente, métricas recentes e dependências.
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}
A priorização é onde o Jev brilha: mais de 10x mais rápido no P90, de 5.4 segundos para cerca de meio segundo, e 34% mais barato. Também é nossa decisão de maior volume, então é responsável pela maior parte da economia total.
P90 latency
Cost per 1,000 calls
Resumo
No geral, o Jev entregou reduções substanciais na latência e no custo estimado por 1,000 chamadas:
- Redução da latência no P90: 4,752 ms —> 508 ms.
- Redução do custo por 1,000 chamadas: $0.76199 —> $0.46369.
P90 latency
ms · lower is betterCost per 1,000 calls
USD · lower is betterPor modelo, o Jev é ao mesmo tempo o mais rápido e o mais barato: um pouco mais barato que o DeepSeek V4.1 Flash, e bem abaixo dos dois modelos GPT-OSS.
Swipe to see every point.
Sempre que nossos agentes escolhem entre um conjunto fixo de respostas, o Jev agora é o padrão: é mais rápido e mais barato em cada decisão que migramos.